
O200K 到底是什么?从 Tokenizer 认识大模型如何阅读中文
O200K 到底是什么?从 Tokenizer 认识大模型如何阅读中文
很多人第一次接触大模型时,都会注意到一个现象:同一句话,换一个模型,Token 数量可能不一样;同一段中文,有时被切成一个词,有时却被拆成好几个小片段。
这不是模型“理解能力”突然变化了,而是模型在真正开始计算之前,先经过了一道预处理:Tokenizer(分词器)。
OpenAI 的 o200k_base 就是这样一套词表和编码规则。它被用于 GPT-4o 等模型。名字里的 200k 容易让人误解成“模型有二十万个词”,但它更准确的含义是:这套编码方案大约包含二十万个可使用的 Token 条目。
Token 不是词典里的“词”,也不是模型已经理解的概念。它只是模型处理文本时使用的一种编号单位。理解这一点,就能解释很多看起来奇怪的现象:为什么一个完整词组可能只占一个 Token?为什么一串空格也可能是一个 Token?为什么中文、英文和代码的 Token 数量差别很大?
一、模型为什么不能直接读取文字?
我们看到的是字符,模型接收的却是一串数字。
原始文字
   ↓
Tokenizer 编码
   ↓
Token ID 序列
   ↓
Embedding 向量
   ↓
Transformer 进行计算
例如,下面这句话在进入模型之前,会先被转换成一组整数:
你好,OpenAI
实际的 ID 会随着所使用的编码方案变化。cl100k_base 和 o200k_base 可能给出不同的切分结果,但后面的模型计算都建立在这些 ID 之上。
因此,Tokenizer 不是模型的一个可有可无的插件,而是模型输入输出链路的一部分。它决定了两件很现实的事情:
- 一段文字会被拆成多少个 Token;
- 模型的上下文窗口和调用费用会怎样计算。
需要注意的是,Token ID 本身没有语义。编号 12345 并不代表“这个词很重要”,也不代表模型对它有特殊偏好。它只是词表中的一个索引。
二、Tokenizer 是怎样把文字切开的?
现在常见的一类方案是 Byte Pair Encoding(BPE,字节对编码),或者在它基础上改造的变体。
可以把它理解成一个“从小片段逐步合并”的过程。
1. 先把文本表示成更基础的单元
为了处理不同语言、符号和代码,Tokenizer 通常不会只依赖“按单词切分”。它会从字节或字符片段出发,这样即使遇到一个词表中没有的新词,也可以退回到更小的单元进行编码。
2. 统计常见的相邻组合
如果某两个片段经常一起出现,训练过程就可能把它们合并成一个更大的片段。英文中的常见词根、中文中的高频词组、代码中的固定符号,都可能通过这种方式获得更紧凑的表示。
可以用一个简化例子表示:
u + n       → un
un + happy  → unhappy
真实算法会涉及更多规则,也不一定以人类熟悉的“单词”为边界。它优化的是语料中的统计规律,而不是语言学上的词法分析。
3. 形成最终词表
经过多轮合并后,频繁出现的片段会进入词表。编码时,Tokenizer 会根据既定的合并规则,把输入尽量表示成合适的 Token 序列。
这也解释了一个常见误区:一个完整中文词组被编码成一个 Token,并不表示模型“专门认识这个概念”;它首先只说明这个片段在训练 Tokenizer 的语料中具有较稳定的统计结构。
三、o200k_base 比 cl100k_base 多了什么?
cl100k_base 大约有十万个条目,o200k_base 则把词表规模扩大到了大约二十万个。词表变大后,编码器可以保存更多常见的多字符片段,因此许多文本的 Token 数量会发生变化。
但“词表扩大一倍”不等于“所有文本都少一半 Token”。实际节省多少,取决于文本内容:
- 高频英文单词通常已经有比较紧凑的表示,变化可能不明显;
- 中文、日文等语言的常见片段可能获得更紧凑的切分;
- 程序代码、标点和特殊格式也会按照自己的统计规律变化;
- 生僻字、随机字符串和新造词仍然可能被拆成多个片段。
所以,判断某种编码方案是否更省 Token,最可靠的方法不是看宣传语,而是拿自己的文本实际测量。
importtiktoken

text = "Tokenizer 会把文字转换成模型可以处理的 Token 序列。"

for name in ["cl100k_base", "o200k_base"]:
    encoding = tiktoken.get_encoding(name)
    tokens = encoding.encode(text)
    print(name, len(tokens), tokens)
同样的测试也适合放在真实项目里:如果应用需要处理大量中文、代码或多语言内容,就应该用自己的数据集比较,而不是只拿一两个例句下结论。
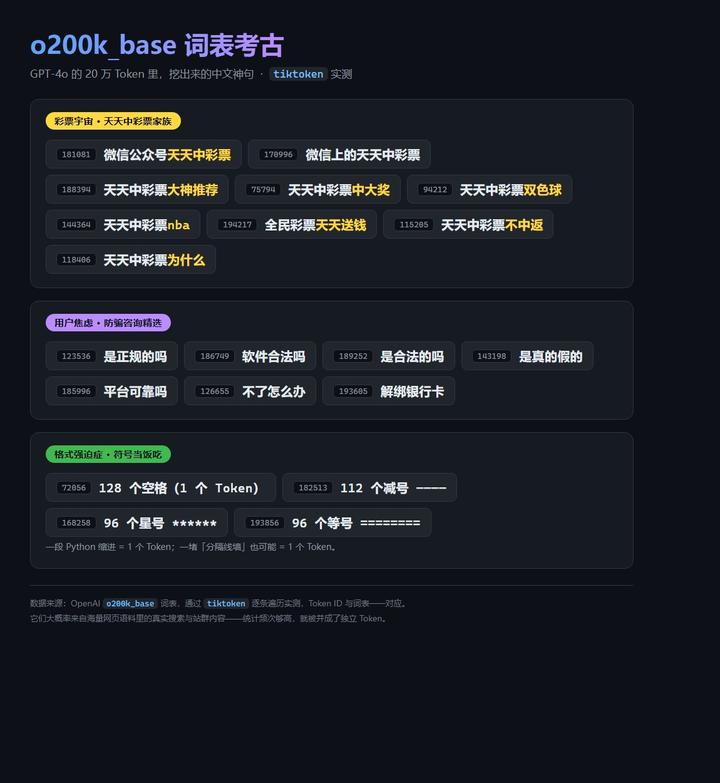
这张图不是我编出来的示意图,而是直接从 o200k_base 词表里按 Token ID 解码出来的结果。最有意思的地方在于:它里面既有“128 个空格”这种纯格式片段,也有一整串非常像网页广告或搜索建议的中文短语。
1. 词表里真的有这些“神句”
下面这些条目都可以用 tiktoken 逐一查到:
| Token ID | 解码结果 |
|---|---|
| 181081 | 微信公众号天天中彩票 |
| 188394 | 天天中彩票大神推荐 |
| 75794 | 天天中彩票中大奖 |
| 94212 | 天天中彩票双色球 |
| 123536 | 是正规的吗 |
| 186749 | 软件合法吗 |
| 193605 | 解绑银行卡 |
把它们放在一起看,确实很像某个年代的网页标题、搜索联想词或自动生成内容。Tokenizer 并不知道这些短语“好不好”,它只是在统计训练语料里哪些片段经常以相同形式出现。
这里需要把事实和猜测分开:我们可以确认这些 Token 真实存在,也可以观察到它们具有明显的网页文本风格;但只凭 Token 本身,不能反推出具体来自哪个网站,也不能证明某一类语料在整个训练数据里占了多大比例。
四、为什么词表里会出现看起来很奇怪的片段?
实际查看词表时,你可能会看到一些不像普通单词的条目:一串空格、重复的标点、带有前置空格的英文片段,或者某些网页和代码中常见的格式。
这并不奇怪,因为 Tokenizer 处理的不是“规范文章”,而是大量真实文本。真实文本里包含:
- Markdown 和 HTML 标签;
- 程序代码和缩进;
- URL、文件路径和日志;
- 论坛格式、复制粘贴痕迹;
- 不同语言混杂的句子;
- 重复的标点和模板化文本。
只要某类片段在训练 Tokenizer 的语料中经常以相同形式出现,它就可能成为一个独立的 Token。这里的“经常出现”是统计意义上的,不代表它有价值,也不代表它被模型赋予了特殊地位。
尤其要注意两点。
1. Token 的边界可能包含空格
英文 Token 经常把前置空格一起编码。例如,hello 和 hello 可能不是同一个 Token。这样做可以让常见的英文句子得到更紧凑的表示,也能减少额外的空格处理。
2. 代码格式也会影响词表
换行、缩进、括号和常用关键字都可能形成稳定的片段。对代码模型来说,这些片段非常有用;对普通读者来说,它们看起来就像“词表里混进了奇怪符号”。
因此,看到一个奇怪 Token 时,比较稳妥的解释是:它反映了训练语料中的某种重复模式。仅凭一个条目,不能推断它来自某个具体网站、某个组织或某种活动。
五、Token 数量为什么和费用有关?
大模型 API 通常按照输入 Token、输出 Token,或者两者的总量计费。Token 数量还会直接占用上下文窗口。
可以把上下文窗口理解成模型一次能放在工作区里的 Token 数量上限。假设一个模型支持 128K 上下文,那么这个上限计算的是 Token,不是字符数,也不是“字数”。
这会带来三个实际影响:
- 同样长度的文本,不同语言可能占用不同数量的 Token。
- 代码、表格、JSON 和日志的 Token 密度可能与自然语言不同。
- 历史消息、工具调用结果和系统提示也会消耗上下文。
所以,在设计 AI 应用时,不能只用“每次传入多少字”来估算成本。更好的做法是抽样统计真实数据,再决定截断、摘要、分块和缓存策略。
这也是 o200k_base 这类编码方案的工程价值:它通过调整词表和合并规则,改善不同文本类型的编码效率。但它不是对所有语言、所有输入都进行同样幅度的优化,更不是简单地把“语言公平”问题一次性解决。
六、Tokenizer 会不会影响模型的表现?
会,但影响方式比“某个词有一个 Token,所以模型一定理解它”复杂得多。
Tokenizer 主要影响以下几个方面:
1. 序列长度
一个意思被拆成更多 Token,模型就需要处理更长的序列。序列越长,计算和上下文管理的压力通常越大。
2. 稀有文本的处理
如果一个词、名字或符号很少见,它可能被拆成字节级的小片段。模型仍然可以处理,但学习这种组合的难度可能更高。
3. 代码和多语言文本
不同语言的文字结构不同,代码又有另一套规律。一个在英文上表现不错的 Tokenizer,不一定能让中文、日文或某种编程语言得到同样紧凑的编码。
4. 输入输出的可控性
在做文本截断、分块或预算控制时,字符数和 Token 数量并不能互相精确替代。真正需要控制长度时,应该使用目标模型对应的 Tokenizer 测量。
但 Tokenizer 不是安全系统的“后门”。把文本变成 Token 之后,模型还会经过训练得到的参数、系统指令、内容审核和应用层逻辑。某个输入被切成特殊片段,并不自动意味着它可以绕过安全控制。关于异常输入的安全问题,需要结合完整的模型和应用链路测试,不能靠词表里的几个例子推导出结论。
七、如何自己观察一套 Tokenizer?
不需要下载一个大模型,只用 tiktoken 就可以进行基本实验。
实验一:比较不同编码方案
importtiktoken

samples = [
    "Tokenizer 是模型读取文本前的一道预处理。",
    "The tokenizer converts text into tokens.",
    "def hello(name):\n    return f\"Hello, {name}\"",
]

for text in samples:
    print("文本:", repr(text))
    for name in ["cl100k_base", "o200k_base"]:
        enc = tiktoken.get_encoding(name)
        ids = enc.encode(text)
        print(f"  {name}: {len(ids)} tokens")
    print()
实验二:查看每个 Token 对应的字节
importtiktoken

enc = tiktoken.get_encoding("o200k_base")
text = "你好,Tokenizer"
ids = enc.encode(text)

for token_id in ids:
    raw = enc.decode_single_token_bytes(token_id)
    print(token_id, repr(raw))
这里使用 decode_single_token_bytes,是因为单个 Token 不一定能独立组成一个合法的 Unicode 字符串。直接对每个 ID 调用普通的 decode,在某些边界情况下可能出现替换字符或与原文不完全一致。
实验三:不要只看一个例子
如果要比较两种 Tokenizer,应该准备一批包含自然语言、代码、数字、链接和多语言文本的样本,然后统计平均值和分布。单个句子的结果只能说明这个句子,不足以代表整种语言或整套编码方案。
八、怎样正确理解“词表考古”?
查看 Tokenizer 词表很有意思,因为它能让我们看到真实互联网文本留下的结构痕迹。但这种观察更接近数据分析,而不是侦探推理。
一个条目的存在,通常只能说明:
- 它在相关语料中以某种形式出现过;
- 编码训练过程认为把它合并起来有统计收益;
- 它可能在某些输入中减少 Token 数量。
它不能单独证明:
- 这个条目来自哪个具体来源;
- 它在训练数据中占了多大比例;
- 模型对它有特殊偏好;
- 它会导致某种必然的输出或安全问题。
把“观察到的条目”与“推测的来源”分开,是理解这类问题最重要的习惯。很多看起来非常有戏剧性的解释,恰恰是从一个真实现象跳到了没有证据支持的结论。
结语:Tokenizer 不是模型的灵魂,而是它的文字接口
o200k_base 最值得理解的地方,不是它的名字有多大,也不是词表里有没有几个奇怪片段,而是它展示了大模型处理文字的基本方式:
- 文字先被编码成 Token ID;
- Token ID 再被转换成向量;
- 模型在向量序列上完成预测;
- 最后再把预测结果解码回人类能读懂的文字。
Tokenizer 决定了文本如何进入模型,也影响上下文长度、运行成本和不同类型文本的处理效率。但它只是整个系统的一层。看到一个有趣的 Token,可以从统计规律、编码方式和实际测试入手;不要急着把它包装成一个关于模型“记忆”或互联网“阴谋”的故事。
真正有用的问题是:
对我的文本来说,这套 Tokenizer 如何切分?它带来了多少成本?在我的应用里,应该怎样利用或规避这种切分结果?
从这个问题出发,才是理解 Tokenizer 的正确入口。
收录于知乎专栏「计算机基础」· 查看知乎原文