
JS逆向:Uleanring复习题库
JS逆向:Uleanring复习题库
很久没更新这个系列了。主要是以前我对js真的不太懂,当时也只是应自己所需靠AI随缘逆向。最近又考试了,来需求了,写篇文总结下最近新成果。
主要是最近看到这个网安兄弟很牛逼啊,据说整到了 Ulearning 的期末考试的答案,还能按学生账号来确定到那个具体的Paper。我逆向下来,得到的结论是不太可能的。除非拿到 authorization 的那个 key 的值去调用开卷接口拿到 paperId 数组再走遍历,而且这也只是题库,每个号考试应该是随机的才对。不可能是指定的Paper。所以…
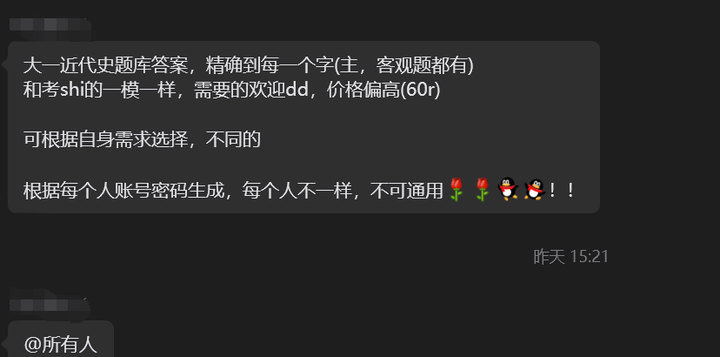
使用场景:
- 任课老师在优学院开放了”练习题库”,要求是可能需要做题 不限次数(当然,有限次我们也测试了接口本身并无访问限制)
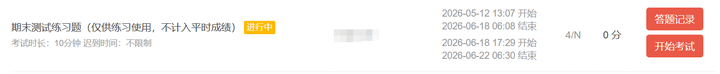
这种就是可以拿到题库的。
逆向过程:
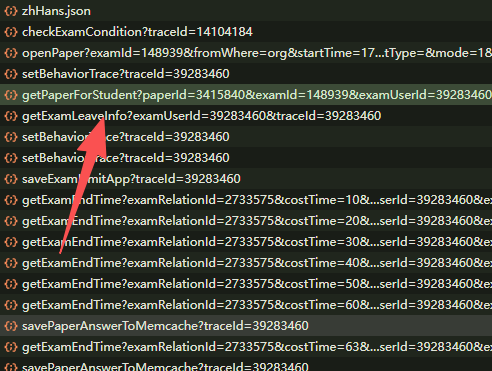
快速做题后打开 devtool,然后去看网络请求。
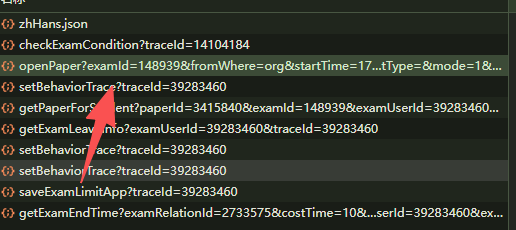
发现 开始做题后会返回一个开卷 openPaper 的接口
请求方法是传 examId,不过还有一些考试起止时间(?不懂干吗用的,我看好像)
这个 reponse body里面有一个 results.paperId 的数组,是专门放各种试卷的id 配合后面说到的接口可以拿到唯一确定的题目。
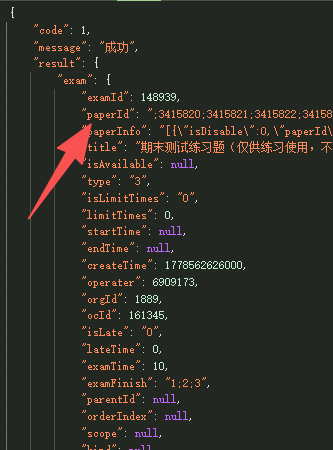
然后用 getPaperForStudent 这个接口 传 paperId 就行。
Get https://utestapi.ulearning.cn/exams/user/study/getPaperForStudent?paperId=3415840&examId=148939&examUserId=39283460&traceId=39283460
参数中 examId、examUserId 和 traceId 虽然必须传递,但后端实际只验证 paperId 和 Authorization 请求头。其他参数可以任意修改而不影响响应结果。
返回的 result.part 里面就有了。
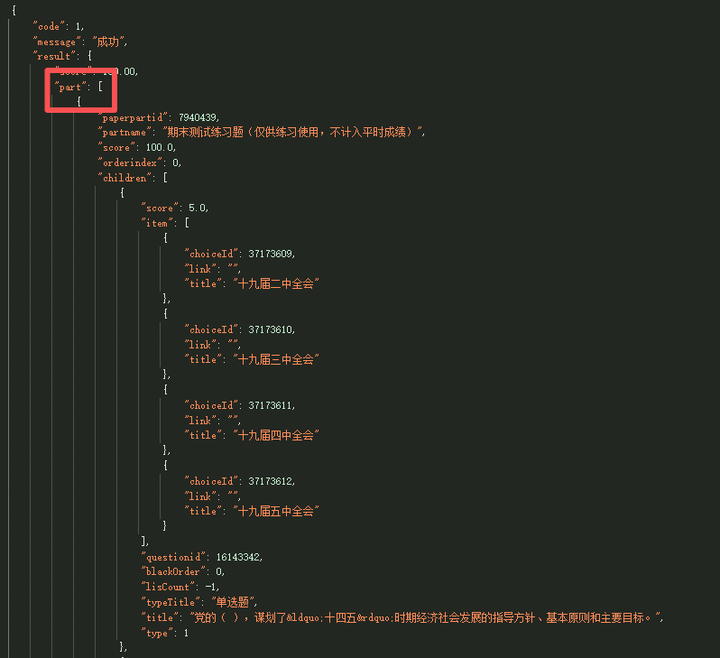
后面 python 遍历一遍 paperId,就能拿到题库了。
关于Authorization 请求头:
后端会验证 Authorization token 的有效性,无效token会返回错误。但经测试发现,只要token有效,就可以访问该用户权限范围内的所有试卷。不同账号的token具有不同的访问范围。
关于连续的paperID:
- 试卷ID完全连续:测试发现100套练习卷的ID从 3415820 到 3415919 顺序递增,可被完全遍历拿到题库。
- 题库规模确认:通过遍历100套试卷(共2000题次),去重后得到612道唯一题目。这证实了系统采用固定题库随机抽题的机制。题目重复率分析:
- 仅出现1次:96题
- 出现2次:147题
- 出现3次:127题
- 出现4-10次:242题
- 平均每题出现:3.27次
- 相邻试卷重合度低:实测相邻试卷间重合率仅0-10%(0-2题重复),而非之前猜测的90%。这说明系统从612道题库中随机抽取20题组卷,但同一paperId多次请求返回结果完全一致。
关于”题组包洗牌”的开发考量
虽然相邻试卷重合度低,但整体采用固定题库随机组卷的方式在业务开发中很常见:
| 开发难点 | 常规临时抽题(实时约束) | 固定题库随机组卷(预置约束) | 省了什么 |
|---|---|---|---|
| 1. 抽题算法 | 需写多维约束引擎:难度占比、知识点覆盖、题型配比、历史曝光率……每次查询要动态计算权重。 | 提前配置好题库,系统只需随机抽取并洗牌。 | 省掉复杂的算法设计与调优,算法复杂度从O(n²)降为O(n)。 |
| 2. 数据库压力 | 高并发下需对百万级题库做带索引的联表查询,还要加ORDER BY RAND()(性能杀手)。 | 只需根据题库范围一次性拉取,内存里洗牌,DB只做主键查询。 | 省掉慢查询优化、缓存设计、读写分离等基建投入。 |
| 3. 公平性保证 | 需要每次考试前预先计算并锁定试卷,否则两次请求可能抽到不同题,还得做”卷号-题目”映射持久化。 | 同一paperId固定对应同一套题,任何时刻任何人抽,核心题不变,天然保证公平。 | 省掉”锁卷”状态机和回滚补偿逻辑。 |
| 4. 测试验证 | 需写自动化脚本验证10万次随机抽取后,难度分布是否在容忍阈值内(统计学验证)。 | 只需验证洗牌算法是否真随机(如Fisher-Yates)以及选项打乱是否对称。 | 省掉大量统计学测试用例,测试用例量减少70%以上。 |
| 5. 教研与开发的协作 | 教研提”难度系数0.7”,开发要去反推数据库里哪个字段映射这个值,还要处理字段缺失。 | 教研直接在后台配置题库,开发只负责”这个范围的题给我取出来”。 | 省掉需求翻译成本,边界清晰,互不甩锅。 |
数据质量问题
需要注意的是,API返回的题目内容包含未解码的HTML实体(如 “、”、  等),需要在使用前进行HTML解码处理。
示例:
原始: 袁世凯准备“登基”前一周,在云南组织“护国运动”并宣布独立的是( )。
解码: 袁世凯准备"登基"前一周,在云南组织"护国运动"并宣布独立的是( )。
统计发现:
 (半角空格):814次“/”(引号):各486次 (不间断空格):11次
关于越权访问的澄清
经过严格测试,未发现越权访问漏洞:
- 参数篡改无效:虽然 examUserId 和 traceId 可以随意修改,但后端有正确的权限验证机制。使用不同的参数值尝试访问权限外的试卷,均返回”试卷信息不匹配”或”考试记录不存在”。
- 访问范围受限:每个token只能访问该用户被授权的特定试卷范围。测试中发现不同账号的访问范围不同,无法通过简单的参数修改实现越权。
总结一下就是:
- 题库可获取性:通过遍历授权范围内的连续paperId(如3415820-3415919),可以获取完整的612道题库。
- 访问控制正常:接口 getPaperForStudent 虽然允许参数篡改,但后端有正确的权限验证,无法越权访问其他用户或课程的试卷。
- 数据完整性:题库数据完整但包含HTML实体编码,需要解码后使用。
声明:
仅供学习使用。以上内容未发现可以在考试前获得试题的可能。
题库可获取,但接口 Unofficial,随时可能失效;相关数据仅限本人学习范围内使用,后果自负。
收录于知乎专栏「js逆向实例」· 查看知乎原文